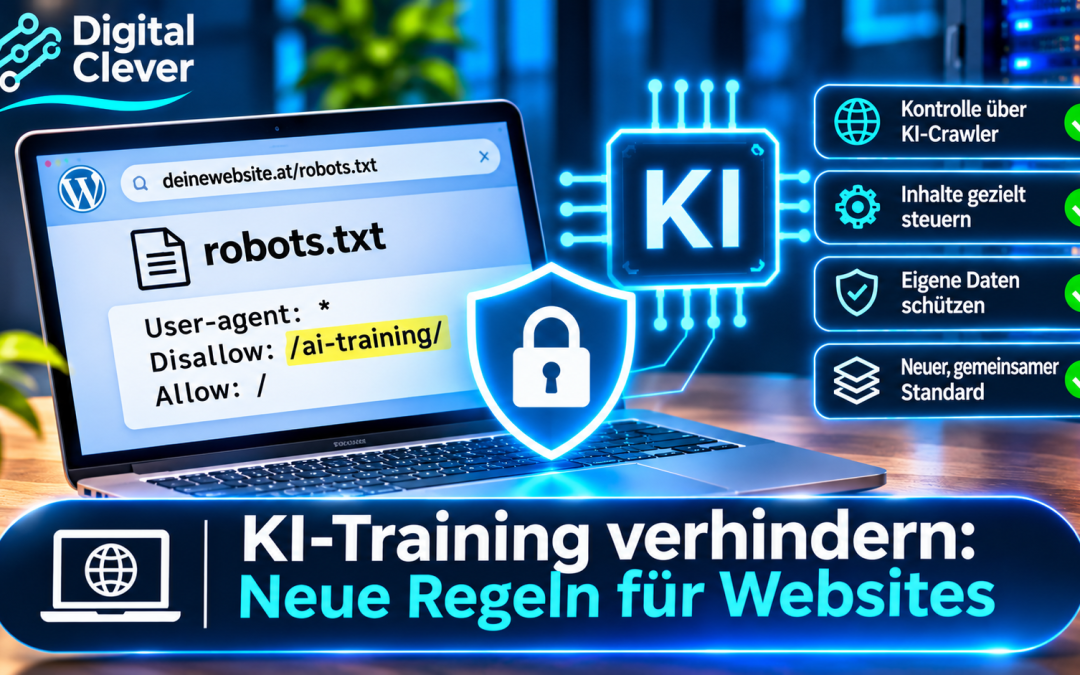
Beitragsbild: KI-generierte Symbolillustration; keine Originalaufnahme, amtliche Benutzeroberfläche oder Live-Kursanzeige.
Texte, Bilder und Informationen von Websites sind für viele KI-Systeme interessant. Doch nicht jeder Website-Betreiber möchte, dass seine Inhalte zum Training künstlicher Intelligenz verwendet werden. Mehrere große Technologieunternehmen unterstützen jetzt einen gemeinsamen Ansatz für entsprechende Einstellungen.
Am 30. Oktober 2026 kündigte OpenAI die Unterstützung eines gemeinsamen Signals in robots.txt an, mit dem Website-Betreiber ihre Präferenzen gegenüber KI-Crawlern einheitlicher ausdrücken können.
Zu den unterstützenden Unternehmen zählen nach den aktuellen Berichten OpenAI, Google, Microsoft und Anthropic.
Für Blogger, Nachrichtenangebote und kleinere Websites ist das ein relevantes Thema.
Warum interessieren sich KI-Unternehmen für Websites?
Generative KI-Systeme werden mit großen Datenmengen entwickelt.
Dazu können öffentlich zugängliche Texte und andere Inhalte gehören, sofern sie im jeweiligen Verfahren rechtmäßig verwendet werden dürfen.
Für Website-Betreiber stellt sich deshalb die Frage, welche automatisierten Zugriffe sie erlauben möchten.
Dabei muss zwischen verschiedenen Nutzungsarten unterschieden werden.
Ein Suchmaschinen-Crawler erfüllt beispielsweise einen anderen Zweck als ein System, das Daten für das Training eines KI-Modells sammelt.
Was ist ein KI-Crawler?
Ein Crawler ist ein automatisiertes Programm, das Webseiten abruft.
Solche Programme werden unter anderem von Suchmaschinen eingesetzt.
Auch KI-Unternehmen können Crawler verwenden.
Je nach Anbieter und technischem Zweck kann ein Zugriff beispielsweise der Suche, der Bereitstellung aktueller Informationen oder der Sammlung von Trainingsdaten dienen.
Nicht jeder automatisierte Besuch einer Website ist deshalb gleich zu bewerten.
Was ist robots.txt?
Die Datei robots.txt liegt üblicherweise im Hauptverzeichnis einer Website.
Sie kann automatisierten Programmen Hinweise geben, welche Bereiche sie abrufen sollen und welche nicht.
Das Verfahren ist seit Langem aus dem Bereich der Suchmaschinen bekannt.
Allerdings ist robots.txt keine technische Zugangssperre.
Ein Crawler muss die angegebenen Regeln auch tatsächlich respektieren.
Was soll sich jetzt ändern?
Der neue Ansatz soll es Website-Betreibern erleichtern, ihre Wünsche zur Verwendung von Inhalten für KI-Zwecke auszudrücken.
Statt für zahlreiche Anbieter unterschiedliche Einstellungen pflegen zu müssen, könnte ein gemeinsamer Mechanismus die Verwaltung vereinfachen.
Wichtig ist jedoch die Unterscheidung zwischen einer angekündigten Unterstützung und einer vollständig eingeführten technischen Lösung.
Ob alle beteiligten Unternehmen dieselben Signale künftig umfassend beachten, hängt von der tatsächlichen Umsetzung ab.
Können Website-Betreiber KI-Training vollständig verhindern?
Eine pauschale Garantie gibt es nicht.
Technische Hinweise können die Nutzung durch kooperierende Crawler beeinflussen.
Sie verhindern aber nicht automatisch jeden unerwünschten Zugriff.
Außerdem müssen rechtliche Fragen rund um Urheberrecht, Text- und Data-Mining sowie mögliche Nutzungsvorbehalte gesondert betrachtet werden.
Wer seine Inhalte schützen möchte, sollte deshalb nicht allein auf eine einzelne technische Einstellung vertrauen.
Was bedeutet das für WordPress?
WordPress-Betreiber können bereits heute verschiedene Einstellungen zur Sichtbarkeit ihrer Website vornehmen.
Dabei ist Vorsicht wichtig.
Wer versehentlich alle Suchmaschinen-Crawler ausschließt, kann die Auffindbarkeit seiner Website beeinträchtigen.
Deshalb sollte vor Änderungen geprüft werden, ob die Einstellung nur bestimmte KI-Zugriffe betrifft oder auch normale Suchmaschinen.
Neue Standards sollten erst dann übernommen werden, wenn ihre technische Funktionsweise und die Unterstützung durch die jeweiligen Dienste ausreichend geklärt sind.
Was ist für Blogger besonders wichtig?
Wer eigene Artikel veröffentlicht, sollte sich mit drei Fragen beschäftigen:
Sichtbarkeit: Soll die Website in normalen Suchmaschinen auffindbar bleiben?
Nutzung durch KI: Welche Formen automatisierter Verwendung sollen zugelassen werden?
Rechte: Welche eigenen oder fremden Inhalte befinden sich auf der Website?
Diese Fragen sind miteinander verbunden, aber nicht identisch.
Fazit
Die Initiative für gemeinsame Signale an KI-Crawler könnte Website-Betreibern künftig mehr Übersicht und Kontrolle geben.
Gerade kleinere Websites könnten davon profitieren, wenn Einstellungen einfacher und verständlicher werden.
Bis ein gemeinsamer Standard zuverlässig umgesetzt ist, sollten Betreiber technische Änderungen sorgfältig prüfen und die Auffindbarkeit ihrer Inhalte im Blick behalten.
Redaktioneller Hinweis
Dieser Artikel wurde von Digital Clever eigenständig anhand aktueller Berichterstattung über gemeinsame KI-Crawler-Standards erstellt.
Redaktionsstand: 31. Oktober 2026.
Die konkrete technische Umsetzung kann sich ändern. Der Artikel stellt keine individuelle Rechtsberatung dar.